我的数据被拿去训练吗
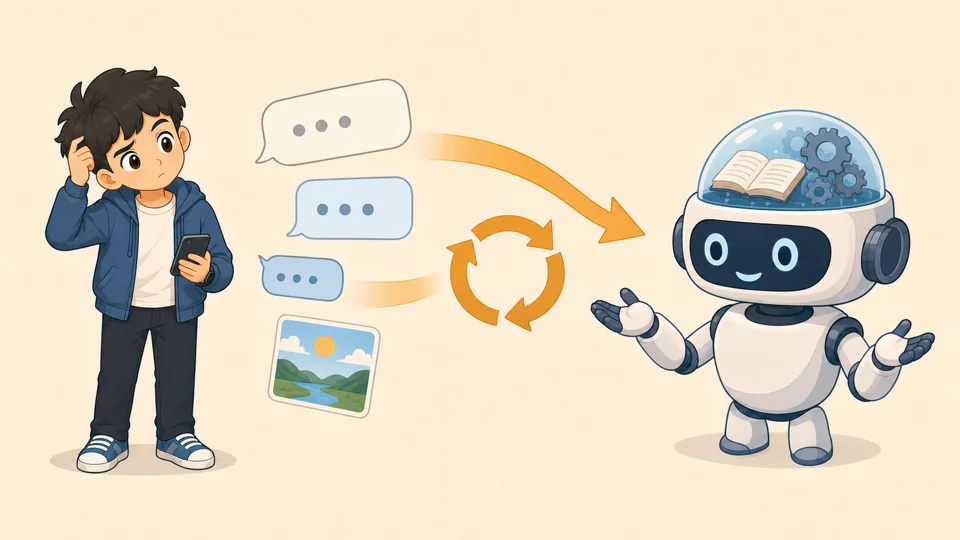
你跟 AI 聊的天、传的图,会不会变成训练它的教材?先凭直觉猜一猜:你随手发给 AI 的一段话,有没有可能被拿去"教"它变得更聪明?
先猜一猜,不用担心猜得准不准,等会儿咱们把这条链路走一遍就知道了。
① 你的数据,走了哪条路?
点一点每一站,跟着数据的旅程走一遍——最后一站有个"分岔点"。
点击上面的每一站,看看那里发生了什么~
情况 A · 用于训练
如果条款写明"会用于训练",你这次的对话或图片,就可能成为模型下一次改进、微调的素材之一。
情况 B · 不用于训练
如果产品承诺"不用于训练",这次的数据通常只服务于这次请求,不会进入训练素材库。
还没点过任何一站
② 动手:在条款里圈出关键信息
下面是一段(示例)隐私说明。看一个 AI 产品讲不讲规矩,就盯这三件事——把它们在条款里点出来:会不会用于训练、能不能关闭、数据保留多久。
在条款里点出三处关键信息。
③ 想一想 🤔
判断一个 AI 产品是否尊重你的数据,最该看什么?
选一个答案,看看小博怎么说。
这一节,你懂数据训练的门道啦!
以后看到一个 AI 产品,先看这 3 件事:
1它有没有明确告诉你,你的输入可能被用来训练/改进模型
2如果会用于训练,你能不能在设置里把这个选项关掉
3隐私条款/服务条款有没有写清楚数据的用途和保留时间
你的数据,可能变成教材
会不会被拿去训练本身不可怕,可怕的是不知道、也不能选。用之前扫一眼条款,是对自己负责的小习惯。再往深里想一层——你的数据被谁用、谁从中获益、又是谁在承担代价?这些问题,思辨层的"数据正义"会带你继续聊。
数据训练关系:你的输入可能被用来改进 AI。
进阶说法:用户生成内容作为模型持续训练/微调的数据来源,涉及数据授权与隐私政策。
进阶说法:用户生成内容作为模型持续训练/微调的数据来源,涉及数据授权与隐私政策。
深入一点:这类"能不能关闭"的设置,是怎么来的?
2018年生效的欧盟《通用数据保护条例》(GDPR)首次大规模要求企业:收集用户数据前必须明确告知用途,并且要给用户拒绝/关闭的权利——这也是为什么现在很多正规 AI 产品的设置里,都能找到"是否用于训练"这类开关,这不是巧合,而是全球隐私法规逐渐趋同的结果。
深入一点:为什么很多产品的隐私条款又长又难读?
2008年,卡内基梅隆大学研究者 Aleecia McDonald 和 Lorrie Cranor 发表过一项研究《隐私政策阅读的代价》,专门估算过:普通网民如果想认真读完自己一年内会遇到的所有网站隐私政策,需要花费的时间远超大多数人的想象——这也是为什么现在有些负责任的产品开始用"一句话摘要"的方式,把关键信息(是否用于训练、能不能关闭)放在最显眼的位置。
经验 +15
金币 +7
会判断+善使用 +1