下棋 AI 是怎么决定走哪一步的?
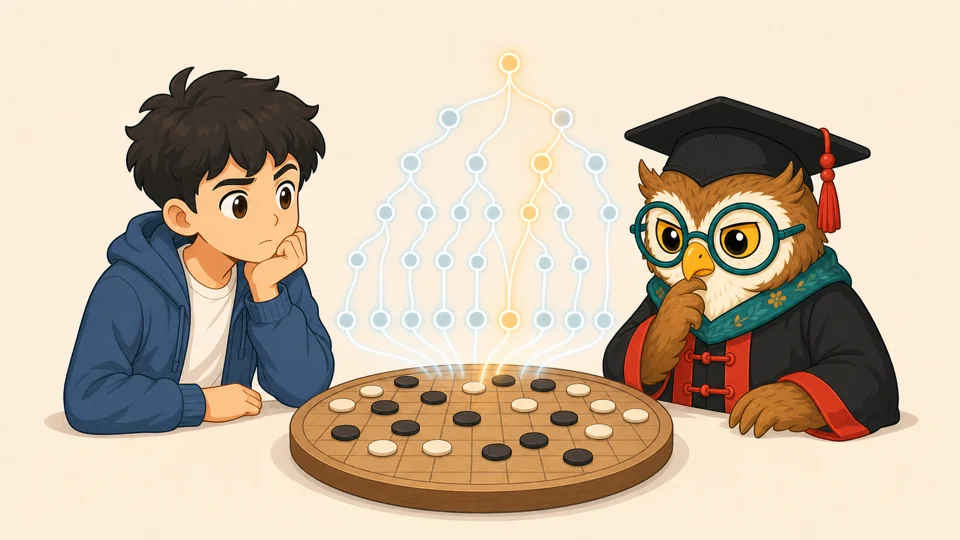
下棋 AI 不是"学"会下棋的,它是把能走的每一步都"想"了一遍。先凭直觉猜一猜:它到底是怎么决定走哪一步的?
选一个就能开始,猜得准不准都没关系。
①棋盘现在长这样,AI 在想什么
轮到 X 走棋。点开下面每张卡片的"揭晓评分",看 AI 把这一步"想"了一遍之后会发生什么。(这里的分数只是示意,帮你直观比较不同走法的好坏,不是算法真实输出的固定数值。)
XOO
OXX
789
揭晓全部3种候选走法才能继续。
②换个局面:AI 会怎么退而求其次?
刚才 9 号格能直接连线获胜。可如果 9 号格突然被对手先占了,只剩 7 号格(评分 45)和 8 号格(评分 55)——这时 AI 会退而求其次挑哪个?
选一个看看你和 AI 想的是不是一样。
③想一想
下棋 AI 和认图 AI,两者的工作方式一样吗?
选一个理由,说说你的判断依据(选填)。
你搞懂了"搜索推理"这种 AI 的想法!
以后遇到类似情况,看这3件事:
1先看它是不是把"能走的每一步"都想了一遍、给每种打分,再挑最高分——这就是搜索推理
2再看它要不要"喂例子学习"——搜索式 AI 不需要海量训练数据,只要规则明确、局面能穷举就行
3最后记住:这和认图 AI"从大量例子里学习规律"是完全不同的思路,别把两种 AI 混为一谈
把可能性都想一遍,挑最好的
下棋 AI 靠展开决策树、给每种走法打分来决策——不是靠"看过很多棋谱学出感觉",这跟认图 AI 从大量例子中学习规律完全是两条路。
搜索推理:把可能性都想一遍再选最优。
进阶说法:博弈树搜索(如 Minimax、蒙特卡洛树搜索)结合评估函数进行决策。
进阶说法:博弈树搜索(如 Minimax、蒙特卡洛树搜索)结合评估函数进行决策。
深入一点:这套"想遍所有可能"的下棋 AI,最早是靠什么赢的?
1997 年 IBM 的"深蓝"(Deep Blue)战胜了国际象棋世界冠军卡斯帕罗夫,靠的就是每秒计算数亿种可能走法、层层展开搜索树再打分挑选——不是靠"看过很多棋谱学出感觉",是货真价实的搜索式 AI。
深入一点:现代围棋 AI(比如 AlphaGo)也是纯靠搜索吗?
不完全是。2016 年 AlphaGo 用的是"搜索+学习"混合:靠蒙特卡洛树搜索(MCTS)展开可能的走法,但局面评分靠一个从海量人类棋谱和自我对弈中学出来的神经网络——因为围棋的可能局面数量远超国际象棋,纯靠穷举搜索算不过来,需要"学习"帮忙判断哪几步值得深入搜索。
经验 +15
金币 +7
懂原理 +1